Der Engpass ist nicht mehr der Code
Eine KI schreibt dir heute ein ganzes Feature in ein paar Minuten. Das ist nicht mehr das Problem.
Das Problem kommt danach: Funktioniert das Ding überhaupt? Du startest die App, drückst dich durch den Flow, schaust auf den Screen, liest Logs, fixt was, Hot Reload, nochmal. Genau diese Schleife bleibt bei dir hängen, auch wenn der Agent längst fertig ist.
Ich habe in meinem Artikel über Solo-Entwickler geschrieben, dass Testing der neue Engpass ist. Auf der FlutterCon 2026 hat Mateusz ein Tool vorgestellt, das genau da ansetzt: Marionette MCP.
Was Marionette ist
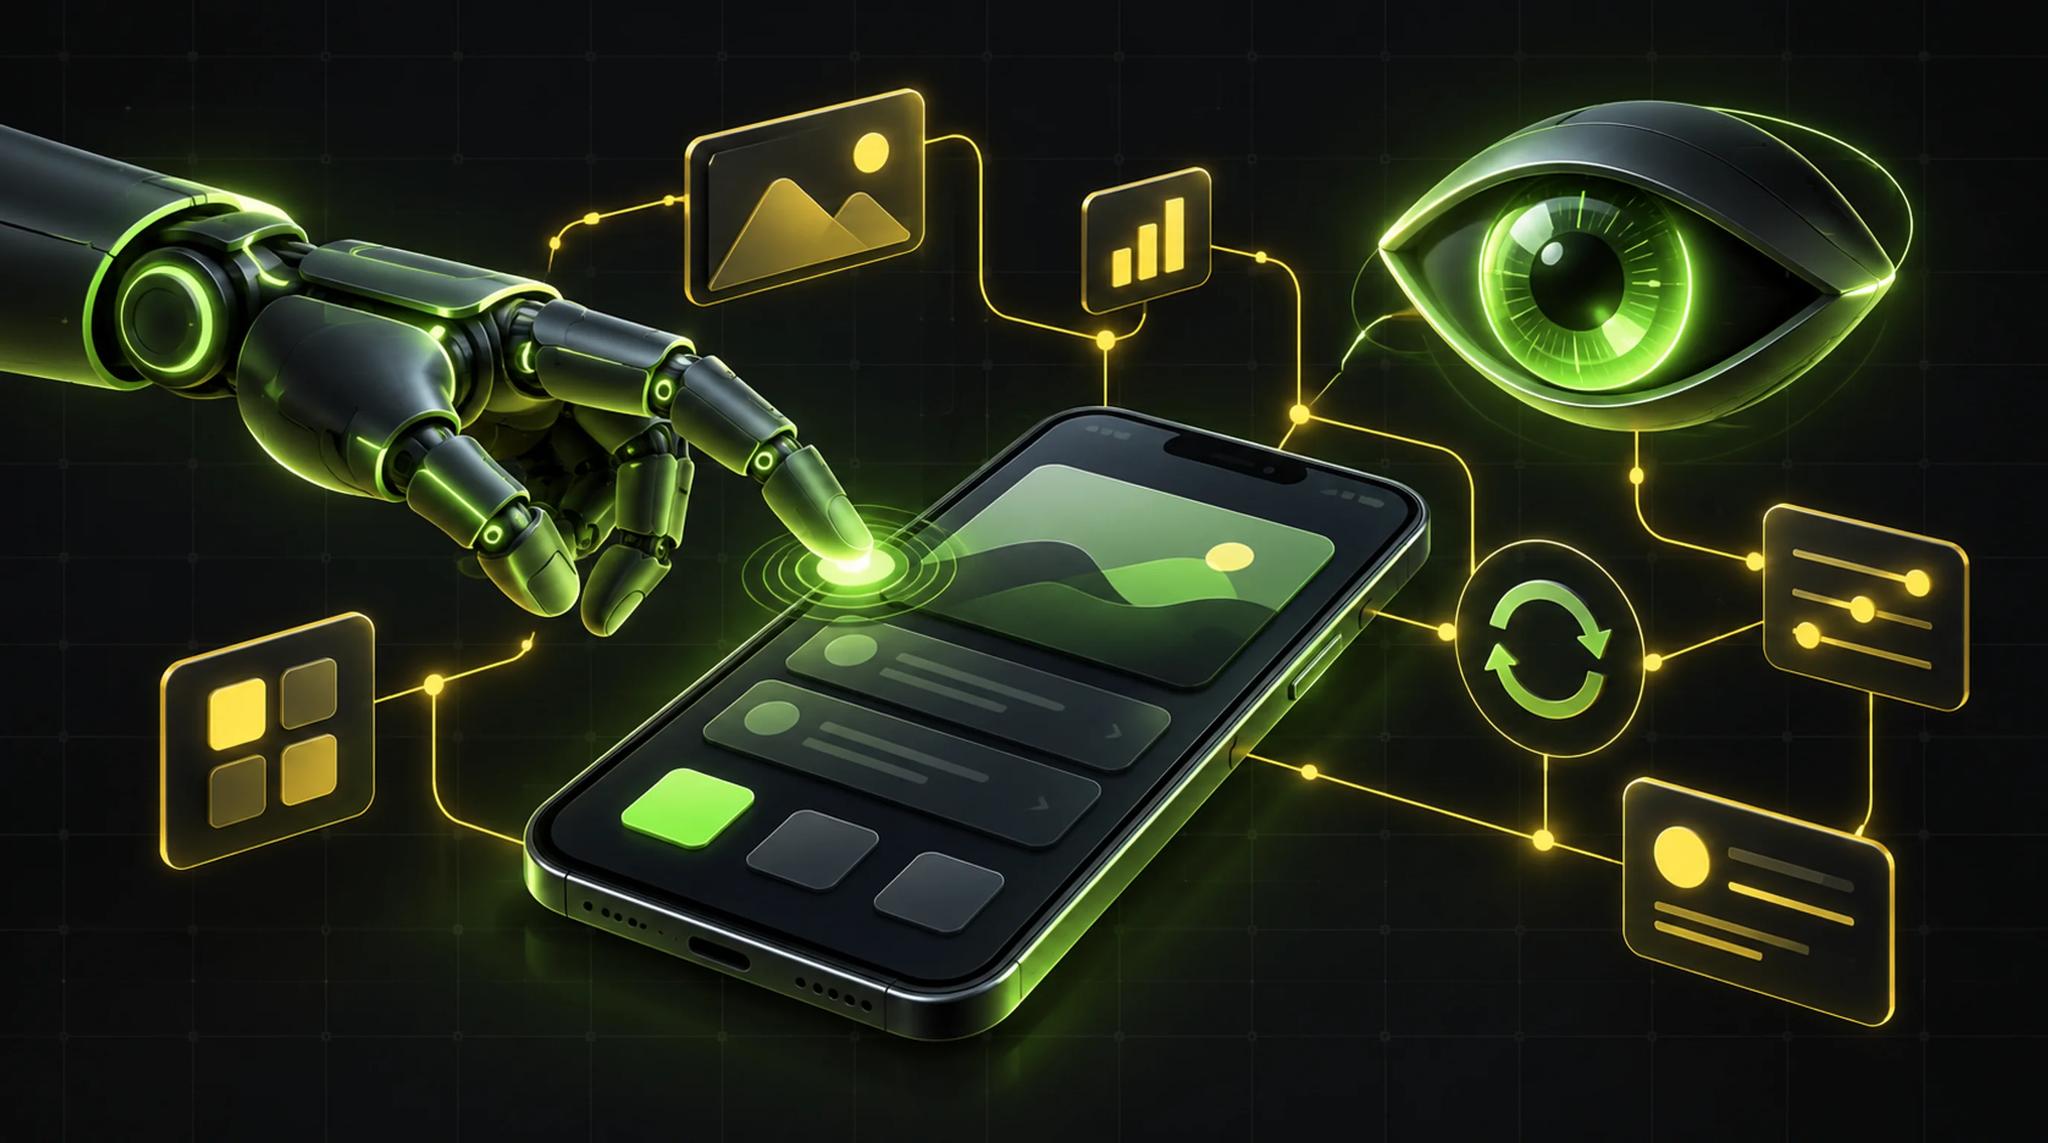
Marionette ist eine Open-Source-Bibliothek für Flutter. Die Idee in einem Satz: Dein KI-Agent bekommt Augen und Hände in der laufenden App.
Der Agent kann also nicht nur Code schreiben, sondern die App starten, ansehen, bedienen und prüfen. Mateusz nennt das "den Loop schließen". Code schreiben, laufen lassen, beobachten, verifizieren, ohne dass du daneben sitzen musst.
Spannend ist die Entstehungsgeschichte. Sie begann mit einem Tweet aus der Flutter-Community, der ein Playwright-MCP für Flutter-Apps forderte. Sein Team hatte intern schon etwas Ähnliches für die eigene Agent-Entwicklung. Neun Tage später war die öffentliche API fertig und Marionette draußen. Das Team steckt übrigens auch hinter Patrol.
Warum Pixel eine schlechte Schnittstelle sind
Der Standardweg für KI-Agenten ist heute "Computer Use". Der Agent macht Screenshots, ruft Shell-Tools wie ADB auf und schreibt zur Not kurze Python-Skripte. Das funktioniert inzwischen ziemlich gut. Aber es hat Schwächen, die Mateusz klar benannt hat:
- Ein Screenshot ist nur ein Pixelhaufen. Das Modell sieht keine Widgets, es muss alles daraus ableiten.
- Ändert sich das Layout, ändert sich das Reasoning. Das Ergebnis ist nicht deterministisch.
- Computer Use ist generisch. Android heißt ADB und UI Automator, iOS braucht Xcode-Tooling, im Web geht es um DOM und HTML. Dazu kommt Desktop. Das sind laut Mateusz drei verschiedene Universen.
Sein Beispiel: In der Konferenz-App des Teams sollte der Agent einen bestimmten Talk in einer Agenda mit 25 Einträgen finden. Mit Marionette dauerte das rund 16 Sekunden und ein paar wenige Tool-Calls. Mit generischem Computer Use waren es etwa zweieinhalb bis drei Minuten, mehr Tokens, mehr Calls. Und bei einem zweiten Lauf kann das Ergebnis anders aussehen, weil der Agent vielleicht mit einem anderen Scroll-Offset startet.
Das deckt sich mit meinem Gefühl. Wenn ein Agent raten muss, wie weit er scrollen soll, ist das Zufall mit Rechenzeit.
Wie Marionette funktioniert
Marionette setzt auf das, was Flutter ohnehin hat. In Debug- oder Profile-Builds läuft der VM Service. Den nutzen auch DevTools und der Debugger. Marionette hängt sich als lokaler MCP-Server dazwischen: auf der einen Seite dein Agent, auf der anderen deine laufende App.
Weil Flutter überall dieselben Widgets hat, gilt dasselbe Protokoll für Android, iOS, Web und Desktop. Du brauchst keine plattformspezifischen Tricks.
Das Setup ist kurz:
- Marionette MCP aktivieren. Laut Mateusz kannst du das den Agenten selbst machen lassen, das dauert Sekunden.
marionette_flutterzur App hinzufügen.- MCP bei deinem KI-Tool registrieren (er nutzt Claude).
- Das Marionette-Binding im Debug-Build initialisieren. Nicht im Release-Build.
Augen und Hände
Die Tools teilt Mateusz in zwei Gruppen.
Augen: Der Agent kann interaktive Elemente abfragen, Screenshots machen und Flutter-Logs lesen. Der wichtige Punkt: Es gibt bewusst keinen kompletten Widget-Tree-Dump. Das Team hat damit angefangen und gemerkt, dass es viel zu viel Kontext ist. Stattdessen kommen nur Elemente, mit denen ein Mensch interagieren kann. In seinem Beispiel waren es rund 150.000 Tokens für den ganzen Screen gegen etwa 3.600 für die interaktiven Elemente. Den Filter kannst du an dein Design-System anpassen.
Hände: Taps, Texteingabe, Scrollen, Swipes und weitere Gesten. Dazu Hot Reload, damit der Loop wirklich läuft.
Erweiterungen: Du kannst eigene Tools registrieren, die über MCP sichtbar werden. Sein Beispiel ist ein Tool namens SeedAgenda, das Testdaten in die App schreibt. Das ist für mich der interessanteste Teil. Jede App hat Zustände, die du zum Testen immer wieder herstellen musst. Das kann jetzt der Agent.
Die Demo: Eine Notiz-Funktion, ohne dass jemand zuschaut
Der Prompt war simpel: Füge zu einer Session in der Agenda eine persönliche Notiz hinzu.
Was der Agent dann gemacht hat, fand ich bemerkenswert:
- Er hat sich zuerst mit der App verbunden und zu der Stelle navigiert, wo das Feature hinsoll. Erst dann hat er programmiert. Laut Mateusz war das nicht vorgegeben.
- Nach dem Coden: Hot Reload, Screen prüfen, Notizfeld finden, per Key ansteuern, Text eingeben, zum Speichern-Button scrollen, tappen.
- Dann raus aus dem Screen und wieder rein, um die Persistenz zu prüfen.
- Dann ein anderer Tab, um zu sehen, ob die Notiz pro Session gilt und nicht für die ganze App.
- Zum Schluss hat er geprüft, ob die Daten im Storage wirklich liegen. Das würde ein Mensch eher nicht tun.
Nach ein paar Minuten war das Feature gebaut und verifiziert. Mateusz konnte in der Zeit einen Kaffee holen. Sein Punkt: Je mehr Agenten du parallel laufen lässt, desto wichtiger ist es, dass sie nicht ständig nach menschlichem Input fragen.
Kosten: Compact Mode und Entscheidungsmodelle
Interessant war auch die ehrliche Zwischenbilanz. Als Computer Use besser wurde, stellte das Team fest: Marionette war schneller, aber nicht immer billiger. Die Antwort war der Compact Mode in Version 0.7. Die Element-Beschreibungen sind kürzer, das Modell braucht keine ausschweifenden Namen. Danach war Marionette wieder schneller und günstiger. Je unvorhersehbarer eine App ist, etwa lange Listen mit unbekannter Scroll-Distanz, desto größer der Vorsprung.
Dann kam der Teil, der mich am meisten überrascht hat: sehr günstige Entscheidungsmodelle. Die Idee ist, dass Marionette beobachtet, ein kleiner Harness die Beobachtung in eine feste Auswahl an Optionen übersetzt, das Modell eine Option wählt und der Harness daraus wieder eine Aktion macht. Computer Use hat unendlich viele Optionen, im Zweifel schreibt das Modell ein 40-Zeilen-Skript. Ein Entscheidungsmodell braucht eine begrenzte Liste. Marionette liefert genau die.
In der Live-Demo wählte das Modell Aktionen oft mit 97 bis 100 Prozent Konfidenz, in einem Fall mit 70. Einen Test, bei dem es zu Listeneintrag 39 scrollen sollte, hat es im Demo-Lauf nicht geschafft. Das hat Mateusz offen gezeigt.
Die Zahlen aus dem Talk:
- Claude mit ADB: etwa 40 Cent pro Aufgabe
- Claude mit Marionette: bis runter auf etwa 10 Cent
- Entscheidungsmodell mit Marionette: Bruchteile eines Cents
Was ich davon halte
Ich arbeite viel mit KI-Agenten, und Verifikation ist bei mir tatsächlich der Teil, der am meisten Zeit frisst. Ich glaube, dass der Ansatz richtig ist: Wenn du das Framework kennst, nutze das Framework, statt dem Modell Pixel zu geben.
Was ich testen werde:
- Marionette bei einem laufenden Kundenprojekt einbauen und schauen, wie viele Review-Runden der Agent allein schafft.
- Eigene Seed-Tools für Zustände, die ich sonst von Hand herstelle.
- Als Ergänzung zu klassischen Tests, nicht als Ersatz. Ein Agent, der einmal durch die App klickt, ersetzt keine saubere Test-Suite in der CI/CD-Pipeline.
Offen bleibt für mich, wie gut das in großen Apps mit vielen Screens und echten Backends klappt. Das weiß ich erst, wenn ich es ausprobiert habe. Mehr zu meinem Blick auf KI im Entwicklungsalltag findest du in KI in der App-Entwicklung.
Fazit
Marionette löst ein konkretes Problem: Agenten schreiben Code schnell, aber prüfen ihn schlecht. Über den VM Service bekommen sie strukturierte Informationen statt Pixel, und das ist schneller, stabiler und mit Compact Mode auch günstiger.
Es ist kostenlos und Open Source. Wenn du mit Flutter arbeitest und KI-Agenten nutzt, ist das ein Experiment von höchstens einer Stunde wert.
Häufig gestellte Fragen (FAQ)
Eine Open-Source-Bibliothek, die KI-Agenten Zugriff auf eine laufende Flutter-App gibt. Der Agent kann Elemente auslesen, Screenshots und Logs holen, tappen, scrollen, Text eingeben und Hot Reload auslösen.
Nein. Laut Talk ist es für Debug-Builds gedacht, optional auch Profile. Die Verbindung läuft über den VM Service, den es im Release nicht gibt.
Nein. Es soll mit den gängigen Agent-Tools laufen. Nur GitHub Copilot brauchte anfangs einen Sonderfix, weil es das MCP-Protokoll etwas anders nutzt. Das ist laut Talk behoben.
Es gibt Marionette CLI auf pub.dev. Dahinter läuft derselbe Code, nur ohne MCP. Gedacht ist das für Unternehmen, bei denen MCP-Server schwer durch die Security-Freigabe kommen.
Meine Einschätzung: nein. Marionette hilft dem Agenten, seine eigene Arbeit direkt zu prüfen. Automatisierte Tests, die bei jeder Änderung laufen, brauchst du trotzdem.
Dieser Artikel wurde inspiriert vom Vortrag "Marionette MCP for Deterministic AI Verification in Flutter Apps" von Mateusz auf der FlutterCon 2026.